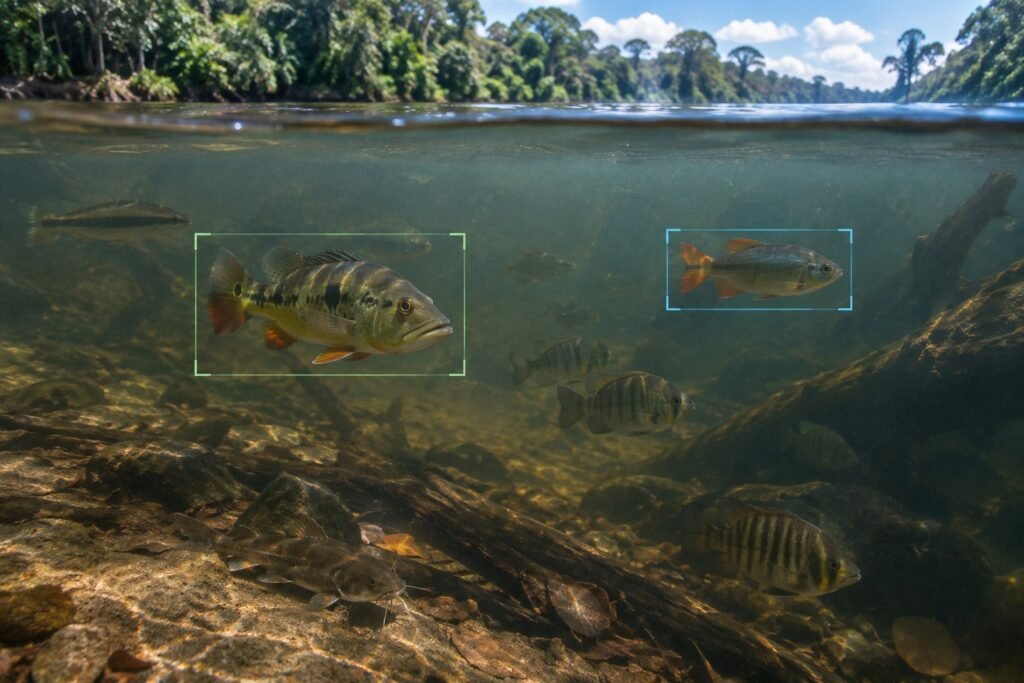
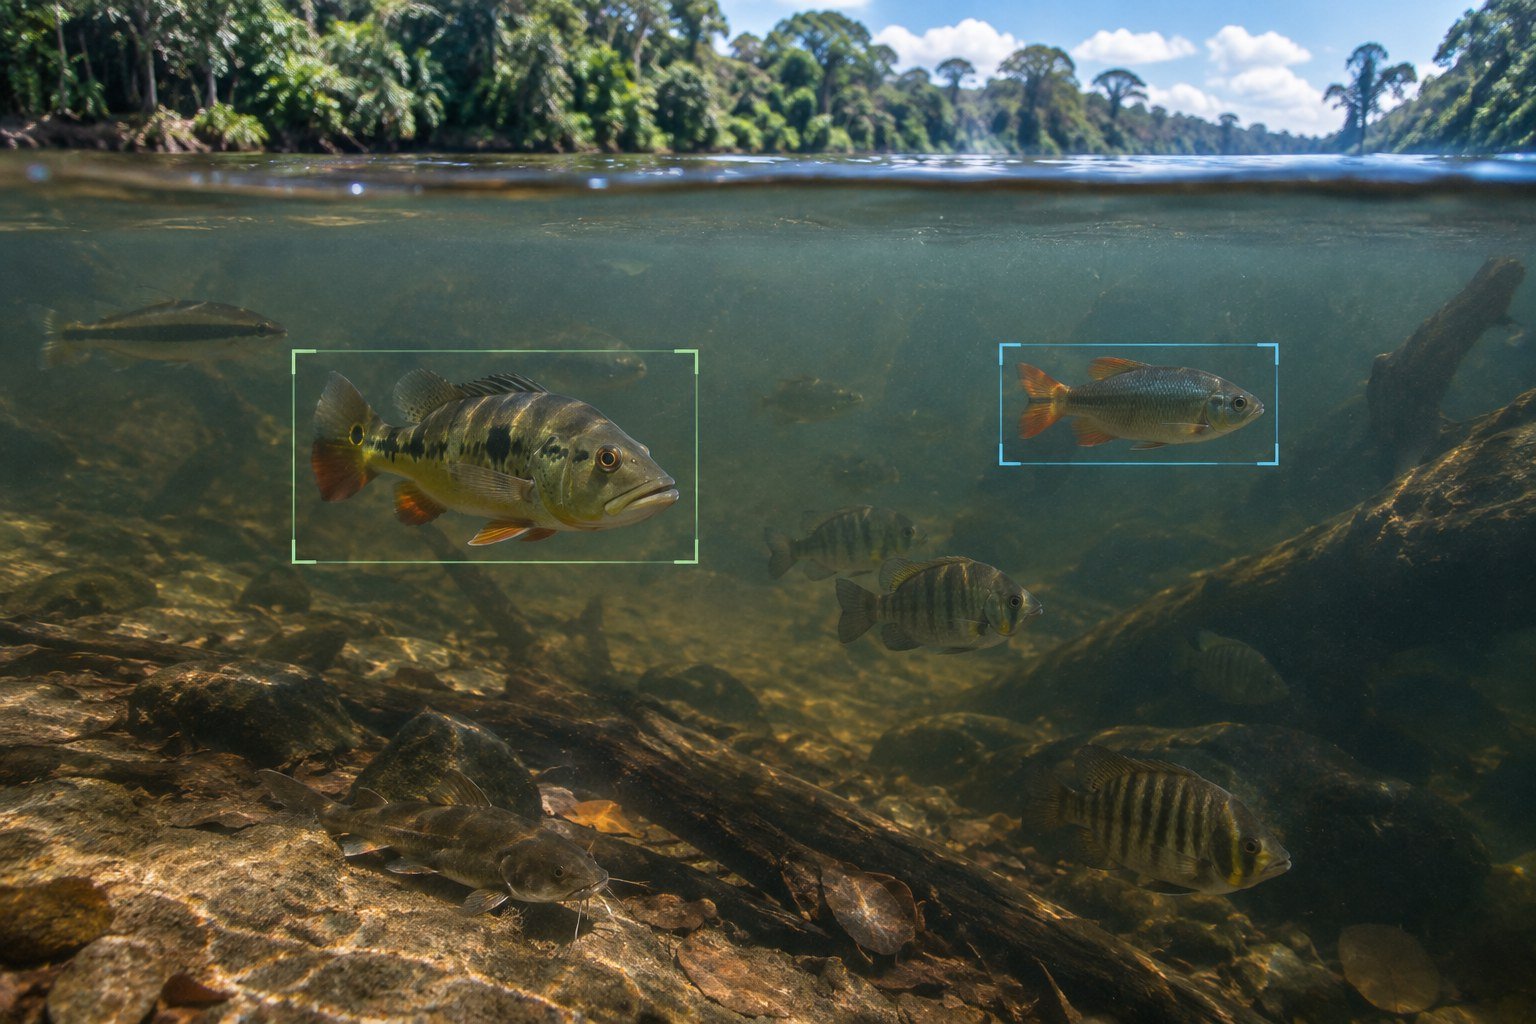
Há uma câmara instalada abaixo da superfície do rio Xingu que observa
a passagem dos peixes durante 24 horas por dia. Ela não se cansa, não
precisa de café e não reclama das condições de iluminação — embora a
água turva lhe dê razões de sobra para isso. Ainda assim, ver não é o
mesmo que compreender.
Para transformar milhares de horas de vídeo em informação útil, é
necessário identificar as espécies, contar ocorrências, acompanhar
períodos de migração e relacionar esses registos com fatores como a
vazão, a turbidez e a época do ano. Até agora, grande parte deste
trabalho depende de amostragens e da observação de especialistas
humanos. Um projeto em desenvolvimento no Complexo Hidrelétrico Belo
Monte pretende acrescentar a esse processo uma ferramenta de visão
computacional.
O caso é um bom ponto de partida para discutir uma relação cada vez
mais importante: o que acontece quando a inteligência artificial
aprende a reconhecer a natureza? A resposta mais honesta não é
“a tecnologia salvará a biodiversidade”. É outra, menos espetacular e
muito mais útil: a IA pode ajudar cientistas e comunidades a observar
melhor, mais vezes e durante mais tempo — desde que os dados sejam
representativos, os erros sejam reconhecidos e as decisões continuem sob
responsabilidade humana.
O
caso do Xingu: transformar imagens em informação ecológica
O sistema chama-se Idarsa — Inteligência de Dados para
Automação de Relatórios Socioambientais. Está a ser
desenvolvido pelo Instituto Atlântico no âmbito de um programa de
investigação, desenvolvimento e inovação da Norte Energia, regulado pela
Agência Nacional de Energia Elétrica do Brasil e apoiado pela
Embrapii.
Segundo informações divulgadas em junho e agosto de 2026 pela Norte
Energia e pelo próprio Instituto Atlântico, uma câmara filma
continuamente uma janela de observação no Sistema de Transposição de
Peixes da Usina Hidrelétrica Pimental, parte do Complexo Belo Monte. O
canal tem cerca de 1,2 quilómetros e permite a passagem de peixes
migratórios. Desde que entrou em funcionamento, em 2016, a estrutura
terá registado mais de 4,3 milhões de peixes de 168 espécies.
O Idarsa pretende identificar automaticamente 60
espécies, escolhidas pela relevância ecológica e pela
importância para a pesca local. O modelo usado pertence à família YOLO —
You Only Look Once —, uma arquitetura de deteção de objetos
capaz de localizar e classificar vários elementos numa imagem numa única
passagem computacional.
Convém separar objetivo de resultado. A equipa prevê que o sistema
alcance maturidade técnica em 2027, com precisão média
superior a 90%. Portanto, no momento em que este artigo é escrito, essa
percentagem é uma meta declarada, não um desempenho
final comprovado em operação. Além disso, uma média pode esconder
diferenças importantes: o modelo pode reconhecer muito bem espécies
abundantes e falhar precisamente nas raras, jovens, parcialmente ocultas
ou visualmente semelhantes.
O que é visão computacional?
Visão computacional é a área da inteligência artificial que permite
extrair padrões e informação de imagens e vídeos. No caso dos peixes, o
processo pode ser resumido em várias etapas:
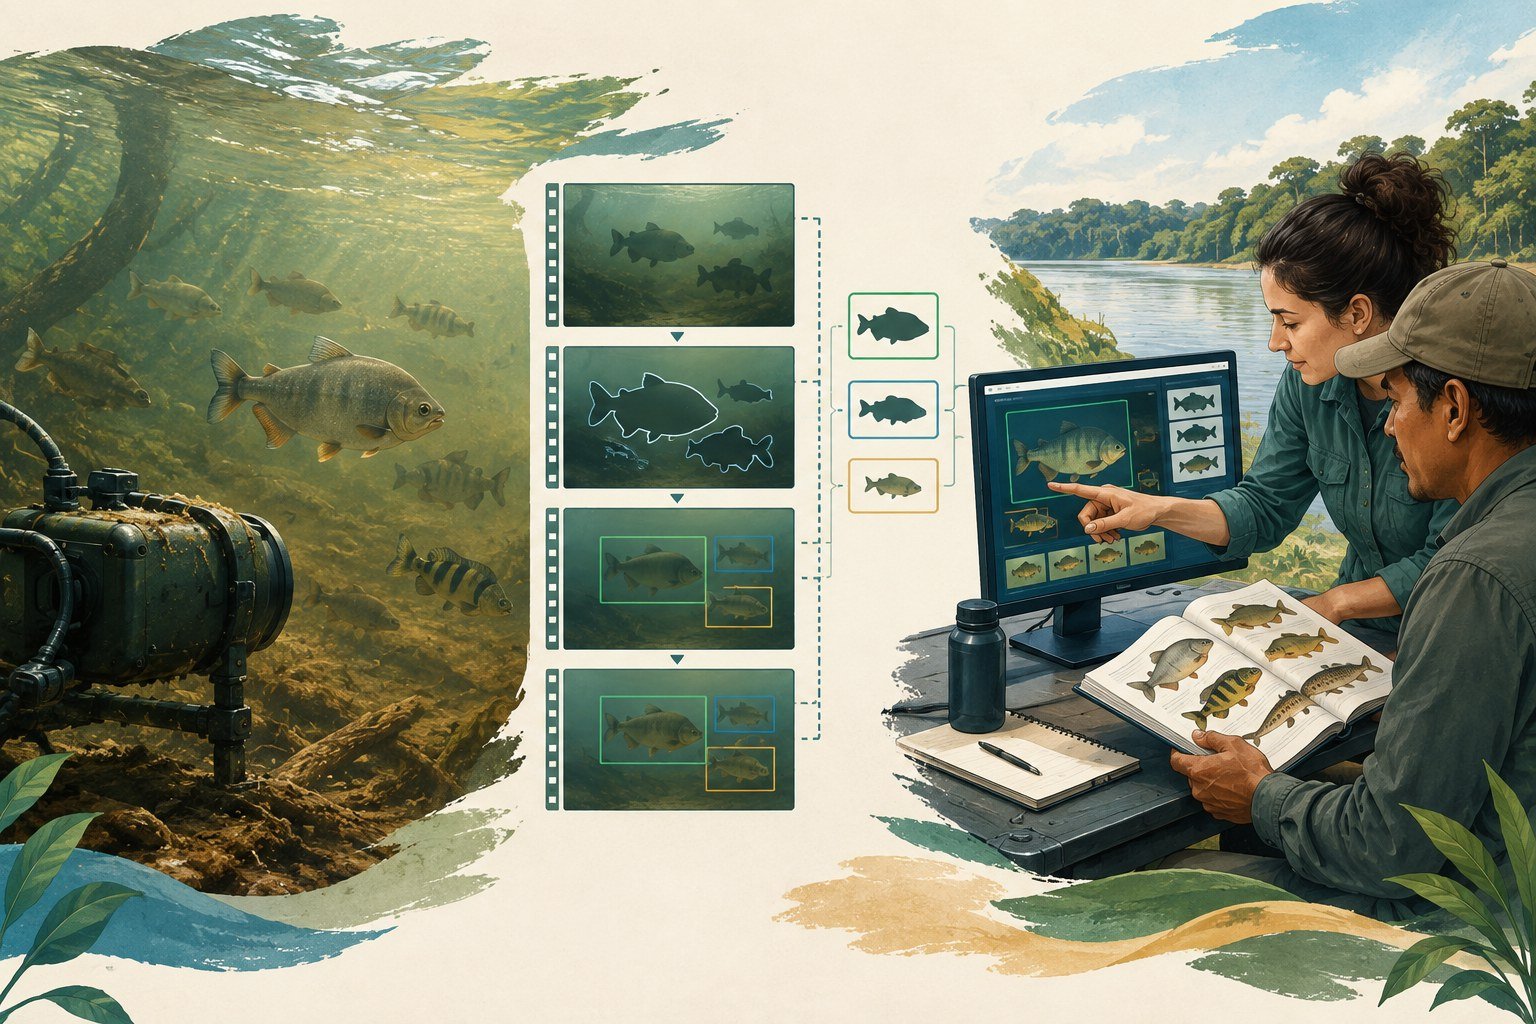
- A câmara capta sequências de vídeo em condições reais.
- Especialistas selecionam e anotam imagens, delimitando os peixes e
atribuindo-lhes uma espécie correta. - O modelo aprende relações estatísticas entre píxeis, formas, cores,
proporções e outros padrões visuais. - Perante uma nova imagem, o sistema indica onde existe um peixe,
sugere uma classificação e apresenta um nível de confiança. - Os resultados são revistos, testados e corrigidos por pessoas
qualificadas.
O algoritmo não “conhece” um peixe como um pescador, uma
investigadora ou uma pessoa que vive junto ao rio o conhece. Não
compreende o papel cultural da espécie, não recorda alterações do
território e não interpreta sozinho o significado ecológico de uma
ausência. Aprende correlações a partir dos exemplos que recebeu.
É justamente por isso que a experiência humana não se torna
dispensável. Torna-se ainda mais estratégica.
Monitorização
não invasiva: observar sem capturar
Uma vantagem importante do vídeo subaquático é a possibilidade de
observar animais sem os capturar, manusear ou retirar do ambiente.
Métodos não invasivos podem reduzir perturbações, repetir observações
com maior frequência e criar séries temporais contínuas.
Uma investigação publicada em 2026 sobre quantificação automatizada
de comunidades de peixes combinou câmaras estereoscópicas, identificação
por aprendizagem profunda, seguimento de múltiplos objetos e
reconstrução tridimensional. Os autores conseguiram estimar diversidade,
abundância e biomassa ao longo do tempo e concluíram que a visão
computacional oferece informação complementar aos censos visuais e ao
ADN ambiental.
“Complementar” é a palavra decisiva. O vídeo não substitui todos os
métodos. Uma espécie pode estar presente fora do campo da câmara, passar
durante uma falha de gravação ou não ser reconhecida devido à turbidez.
O ADN ambiental pode indicar presença sem oferecer uma contagem fiável.
A captura científica permite medições e análises que uma imagem não
fornece, mas envolve custos e perturbação. Combinar métodos tende a
produzir uma leitura mais robusta do ecossistema.
O
conhecimento humano antes, durante e depois do modelo
Não existe um bom sistema de reconhecimento de espécies sem
taxonomia, ecologia de campo e anotação especializada. Antes do treino,
biólogos e taxonomistas determinam quais categorias fazem sentido.
Durante o desenvolvimento, corrigem exemplos ambíguos. Depois da
implementação, investigam falsos positivos, falsos negativos e
alterações no ambiente que podem degradar o desempenho.
No Xingu, o desafio é particularmente exigente. Muitas espécies
possuem morfologias semelhantes; juvenis podem diferir dos adultos; a
posição do peixe altera a aparência; sedimentos reduzem a visibilidade;
e a luz varia ao longo do dia. O movimento rápido pode criar desfoque.
Um animal pode aparecer apenas parcialmente ou sobrepor-se a outro.
Há ainda conhecimento que não está contido numa imagem. Pescadores e
comunidades ribeirinhas reconhecem mudanças sazonais, comportamentos e
relações entre espécies, locais e ciclos hidrológicos. Integrar esse
conhecimento exige participação real, consentimento e retorno de
benefícios — não apenas recolher informação local para enriquecer uma
base de dados externa.
Esta visão está alinhada com uma ideia que já defendemos no artigo Como usar a
inteligência artificial para otimizar o tempo — sem deixar que ela pense
por si: automatizar tarefas não significa abdicar do pensamento, da
experiência ou da responsabilidade.
Quando
os dados estão incompletos, a confiança também deve ter limites
Os modelos de IA refletem os dados usados no treino. Se uma espécie
aparece milhares de vezes e outra surge apenas em poucas imagens, o
sistema aprende de forma desigual. Esse desequilíbrio de classes é
frequente em biodiversidade: as espécies raras, ameaçadas ou sazonais
são precisamente aquelas para as quais existem menos exemplos.
Um conjunto de dados recolhido num único local também pode não
representar outras zonas do rio. Mudanças de câmara, iluminação,
turbidez ou estação podem provocar distribution shift: o
ambiente operacional afasta-se daquele em que o modelo foi treinado. Um
sistema com ótimo desempenho num teste controlado pode perder precisão
no terreno.
Por isso, não basta anunciar “90% de precisão”. É necessário
perguntar:
- Precisão sobre quais espécies e em que condições?
- Quantos falsos negativos ocorreram nas espécies raras?
- O mesmo peixe pode ser contado mais de uma vez?
- Como são tratados resultados de baixa confiança?
- Quem valida as classificações e com que frequência?
- O modelo continua a ser testado em diferentes estações e níveis de
turbidez?
Uma boa prática é permitir que o sistema declare incerteza. Forçar
uma classificação para todas as imagens cria uma aparência de certeza
que a evidência não sustenta. Em conservação, um “não sei” bem
sinalizado pode ser mais valioso do que uma resposta rápida e
errada.
A IA
não é neutra — e o contexto de Belo Monte também não
Aplicar IA num sistema associado a uma grande infraestrutura
hidroelétrica exige cuidado crítico. A tecnologia pode melhorar a
monitorização, mas não apaga debates sobre impactos ambientais,
conectividade fluvial, pesca, deslocamentos ou direitos das populações
atingidas. Um painel inteligente não transforma automaticamente uma
intervenção num projeto sustentável.
Esse cuidado relaciona-se diretamente com o nosso artigo Greenwashing:
quando a sustentabilidade vira maquilhagem de marketing. Inovação
ambiental responsável exige indicadores transparentes, auditoria,
publicação de limitações e abertura à análise independente. A IA deve
ajudar a formular e testar perguntas — não funcionar como selo
decorativo de modernidade.
Ao mesmo tempo, rejeitar uma ferramenta apenas por estar associada a
um contexto controverso também pode impedir conhecimento relevante. O
caminho mais sério é avaliar o sistema pelos seus métodos, governança,
transparência e contribuição efetiva para decisões ambientais.
Ética e soberania dos
dados ambientais
Dados sobre biodiversidade têm valor científico, económico, cultural
e político. A localização de espécies raras pode apoiar a conservação,
mas também facilitar captura ilegal, biopirataria ou exploração
comercial. Informações sobre territórios e práticas tradicionais podem
ser retiradas do contexto e usadas sem consentimento.
É aqui que a soberania dos dados ambientais se torna essencial: quem
decide o que é recolhido, como é descrito, onde fica armazenado, quem
pode aceder, durante quanto tempo e com que finalidade?
Os princípios CARE para a Governança de Dados
Indígenas oferecem uma referência útil. A sigla corresponde a
benefício coletivo, autoridade para controlar, responsabilidade e ética.
Eles complementam os princípios FAIR — dados localizáveis, acessíveis,
interoperáveis e reutilizáveis — lembrando que “aberto” não deve
significar “livre de direitos, relações e consequências”.
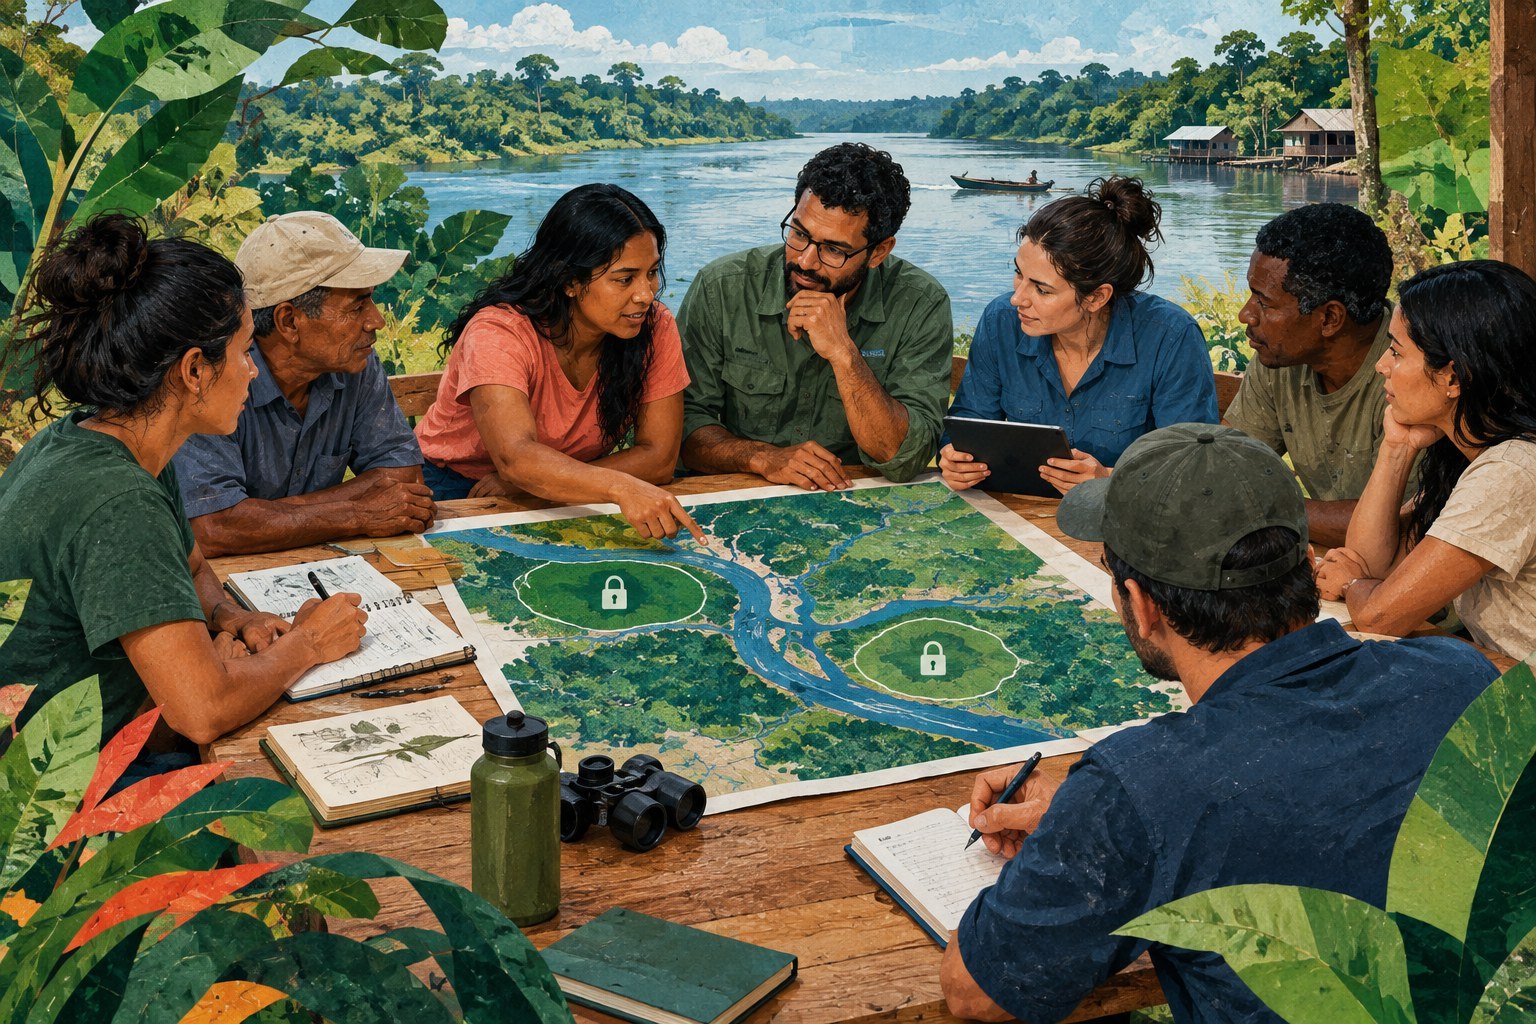
Uma governança responsável deveria incluir, pelo menos:
- participação das comunidades desde a definição das perguntas;
- consentimento para recolha e uso de conhecimento local;
- regras de acesso para dados sensíveis;
- registo de proveniência e alterações;
- mecanismos para corrigir dados e interpretações;
- distribuição clara dos benefícios científicos, sociais e
económicos; - formação e acesso local às ferramentas e aos resultados;
- possibilidade de recusar usos futuros incompatíveis com o acordo
inicial.
Nem toda a informação ambiental deve estar aberta ao público. A
transparência pode exigir explicar por que certos dados estão
protegidos, sem revelar o conteúdo que precisa de proteção.
O custo
ambiental da própria inteligência artificial
Também não devemos esquecer que sistemas digitais consomem energia,
equipamentos, conectividade e capacidade de armazenamento. Guardar vídeo
contínuo em alta resolução e treinar modelos complexos tem uma pegada
material. A solução precisa ser proporcional ao problema.
Isso implica escolher modelos eficientes, limitar retenção
desnecessária, processar dados localmente quando possível, usar
infraestruturas energéticas responsáveis e medir se a informação
adicional realmente melhora decisões. Tecnologia ambiental que acumula
dados sem propósito torna-se apenas arquivo — com fatura elétrica.
O debate aproxima os pilares de Inteligência
Artificial e Sustentabilidade:
inovação só cria valor quando os seus custos, limites e efeitos são
tratados com honestidade.
Da deteção
à decisão: onde está o verdadeiro impacto?
Reconhecer espécies é uma etapa, não o resultado final. O impacto
surge quando dados fiáveis ajudam a responder perguntas concretas: os
períodos migratórios estão a mudar? Há espécies que deixaram de
aparecer? A passagem varia com a vazão? O sistema de transposição mantém
conectividade adequada? Que medidas devem ser ajustadas?
Para isso, os resultados precisam de integrar séries históricas,
variáveis ambientais e conhecimento de campo. Precisam também de chegar
a quem decide — autoridades, investigadores, gestores e comunidades —
num formato compreensível e passível de contestação.
Uma IA que produz milhares de classificações sem alterar nenhuma
decisão é apenas uma máquina muito aplicada a preencher relatórios. Uma
ferramenta realmente útil reduz o trabalho repetitivo, melhora a
frequência das observações, assinala anomalias e liberta especialistas
para interpretar padrões e agir.
Sete
critérios para uma IA verdadeiramente útil à biodiversidade
- Problema ecológico claro: começar pela pergunta
científica, não pela tecnologia disponível. - Dados representativos: incluir espécies raras,
estações, idades, posições e condições de visibilidade diferentes. - Validação independente: testar o modelo com dados
que não participaram no treino e divulgar resultados por espécie. - Supervisão humana: encaminhar casos incertos para
especialistas e conservar a possibilidade de correção. - Participação comunitária: reconhecer conhecimentos
locais, consentimento e direito de decisão. - Governança responsável: proteger localizações,
saberes e outros dados sensíveis. - Efeito verificável: demonstrar como a informação
melhora investigação, gestão ou conservação.
Conclusão:
ensinar a máquina sem silenciar o rio
O projeto do Xingu mostra uma aplicação promissora da visão
computacional: transformar um enorme fluxo de imagens em observações
ambientais mais frequentes e organizadas. Pode reduzir trabalho
repetitivo, complementar métodos não invasivos e revelar padrões que
seriam difíceis de encontrar manualmente.
Mas o sistema não observa a natureza a partir de lugar nenhum. Foi
concebido por instituições, treinado com escolhas humanas e aplicado num
território onde existem histórias, conflitos, direitos e conhecimentos.
Os seus erros também não são neutros: deixar de reconhecer uma espécie
rara pode ter consequências diferentes de confundir duas espécies
abundantes.
A melhor inteligência artificial para a biodiversidade não é aquela
que promete substituir cientistas, pescadores ou comunidades. É a que
torna visíveis os seus limites, aceita correção, protege dados sensíveis
e amplia a capacidade coletiva de compreender e cuidar.
A natureza não precisa de uma salvadora digital. Precisa de decisões
responsáveis, ciência persistente, comunidades respeitadas e ferramentas
à altura dessas relações. A IA pode ser uma delas — útil, poderosa e
devidamente acompanhada por seres humanos que saibam que reconhecer um
peixe é apenas o começo de aprender a escutar um rio.
Fontes técnicas e
leitura complementar
- Norte
Energia — Projeto inédito no Brasil usa IA para monitorar peixes do rio
Xingu, 2026. - Instituto
Atlântico — projeto de IA para monitorizar peixes no rio Xingu, 10
de agosto de 2026. - Memória
da Eletricidade — Projeto da Norte Energia usa IA para monitorar peixes
do rio Xingu, 15 de junho de 2026. - Automated high-frequency
quantification of fish communities and biomass using computer
vision, 2026. - AquaMonitor: dataset para
monitorização realista de biodiversidade aquática, 2025. - The
CARE Principles for Indigenous Data Governance, Data Science
Journal, 2020. - Global Indigenous Data
Alliance — CARE Principles, consulta em setembro de 2026.
Negócios com Alma · NEXA360®
Ver todos os conteúdos →